このページの内容
結論:pip install "paddleocr[doc-parser]" を実行し、PPStructureV3().predict("file.pdf") を呼び出して、各ページで save_to_markdown() を呼びます。表は HTML、数式は LaTeX で出力されます。私たちの 4 コア CPU では 1 ページあたり約 13〜15 秒でした。知っておきたいポイントが 1 つあります。3.7 のパイプラインは今もテキストを PP-OCRv5 のモデルで読み取っています。PP-OCRv6 のモデルを指定すると、請求書のテキストの誤りがすべて直り、しかも速くなりました。
PP-StructureV3 でできること#
PP-StructureV3 は 2025 年 5 月の PaddleOCR 3.0 で登場し、それ以前のレイアウト解析パイプラインを土台にしています。レイアウト・表・数式のモデルが改良され、グラフの理解、多段組の読み順、Markdown 出力が加わりました。15 中身は十数個の小さなモデルをつないだもので、それぞれ use_* フラグでオン・オフを切り替えます。
以下は PaddleOCR 3.7.0 が実際に読み込む既定のモデルです。これらは PaddleOCR 自身のドキュメントではなく PaddleX 3.7.2 のパイプライン設定に書かれているため、意外に感じるものもあります。3
| 処理 | 既定のモデル | 既定で有効? | スイッチ |
|---|---|---|---|
| レイアウト検出 | PP-DocLayout_plus-L | 常に有効 | — |
| 領域(段組)検出 | PP-DocBlockLayout | はい | use_region_detection |
| テキスト検出/文字認識 | PP-OCRv5_server_det / PP-OCRv5_server_rec | 常に有効 | — |
| 表 | PP-LCNet_x1_0_table_cls が罫線あり/なしを判定、構造は SLANeXt_wired / SLANet_plus、セル検出は RT-DETR-L | はい | use_table_recognition |
| 数式 | PP-FormulaNet_plus-L | はい | use_formula_recognition |
| 印影(スタンプ) | PP-OCRv4_server_seal_det | いいえ | use_seal_recognition |
| グラフ → 表 | PP-Chart2Table(0.58B パラメータ) | いいえ | use_chart_recognition |
| ページの向き/歪み補正 | PP-LCNet_x1_0_doc_ori / UVDoc | いいえ | use_doc_orientation_classify、use_doc_unwarping |
| テキスト行の向き | PP-LCNet_x1_0_textline_ori | いいえ | use_textline_orientation |
注意点が 2 つあります。使い方ガイドには罫線なしの表用として SLANeXt_wireless が載っていますが、設定が読み込むのは SLANet_plus です。13 また、PP-StructureV3 は PP-DocLayoutV2/V3 を使いません。これらは PaddleOCR-VL のモデルです。両者のトレードオフとして、PP-StructureV3 はセル単位とテキスト行単位の座標を返しますが、VL シリーズは返しません。5
インストール#
PP-StructureV3 には、PaddleOCR 本体に加えて doc-parser extra と推論エンジンが必要です。私たちが使ったコマンドは次のとおりです。4
python -m pip install paddlepaddle==3.2.0
python -m pip install "paddleocr[doc-parser]==3.7.0" python-docx
python -m pip install paddlepaddle-gpu==3.2.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/
python -m pip install "paddleocr[doc-parser]==3.7.0" python-docxこの extra は paddlex[ocr,genai-client] を導入し、BeautifulSoup、lxml、openpyxl、pypdfium2、scikit-learn、tokenizers などが入ります。この extra には Python 3.9 以降が必要です。python-docx を加えているのは extra に含まれていないためで、これがないと Word 出力と CLI の --save_path が失敗します(詳細)。paddlepaddle==3.2.0 に固定しているのは、PyPI の現行リリース 3.3.1 では、私たちのテストで PaddleOCR 3.7.0 が CPU 上でクラッシュしたためです(詳細と解決策)。
extra を入れずにパイプラインを作成すると失敗します。私たちが再現したエラーは次のとおりです。
RuntimeError: A dependency error occurred during pipeline creation. Please refer to the installation documentation to ensure all required dependencies are installed.
(caused by DependencyError: `PP-StructureV3` requires additional dependencies. To install them, run `pip install "paddlex[ocr]==<PADDLEX_VERSION>"` if you're installing `paddlex` from an index, ...)
解決策は pip install "paddleocr[doc-parser]" です。メッセージは paddlex[ocr] を直接インストールするよう勧めており、それでも動きますが、PaddleOCR が固定しているバージョンとずれやすくなります。
クイックスタート:Python と CLI#
from paddleocr import PPStructureV3

pipeline = PPStructureV3(
    use_doc_orientation_classify=False,   # already the default; set True for rotated scans
    use_doc_unwarping=False,              # set True for photographed, curved pages
)
for res in pipeline.predict("invoice.png"):
    res.print()                                  # structured result in the terminal
    res.save_to_markdown(save_path="output")     # output/invoice.md + output/imgs/
    res.save_to_json(save_path="output")         # output/invoice_res.json
    res.save_to_img(save_path="output")          # layout, OCR and reading-order overlays
paddleocr pp_structurev3 -i invoice.png --save_path ./output
# GPU, and the switches you'll use most
paddleocr pp_structurev3 -i scan.pdf --device gpu:0 \
--use_doc_orientation_classify True --use_chart_recognition True --save_path ./output最初の実行で、既定のモデルがすべて ~/.paddlex/official_models/ にダウンロードされます。CLI の --save_path は、Word 出力も含め、登録されているすべての保存メソッドをページごとに呼び出します。そのため python-docx なしで CLI を実行したところ、Markdown、JSON、HTML、XLSX、画像までは書き出されたものの、ModuleNotFoundError: No module named 'docx' で止まり、終了コードは 1 でした。94 デバイスは自動で選ばれます(使える場合は GPU 0)。固定したいときは device="cpu" または device="gpu:0" を渡します。
実際の出力:請求書と論文のページ#
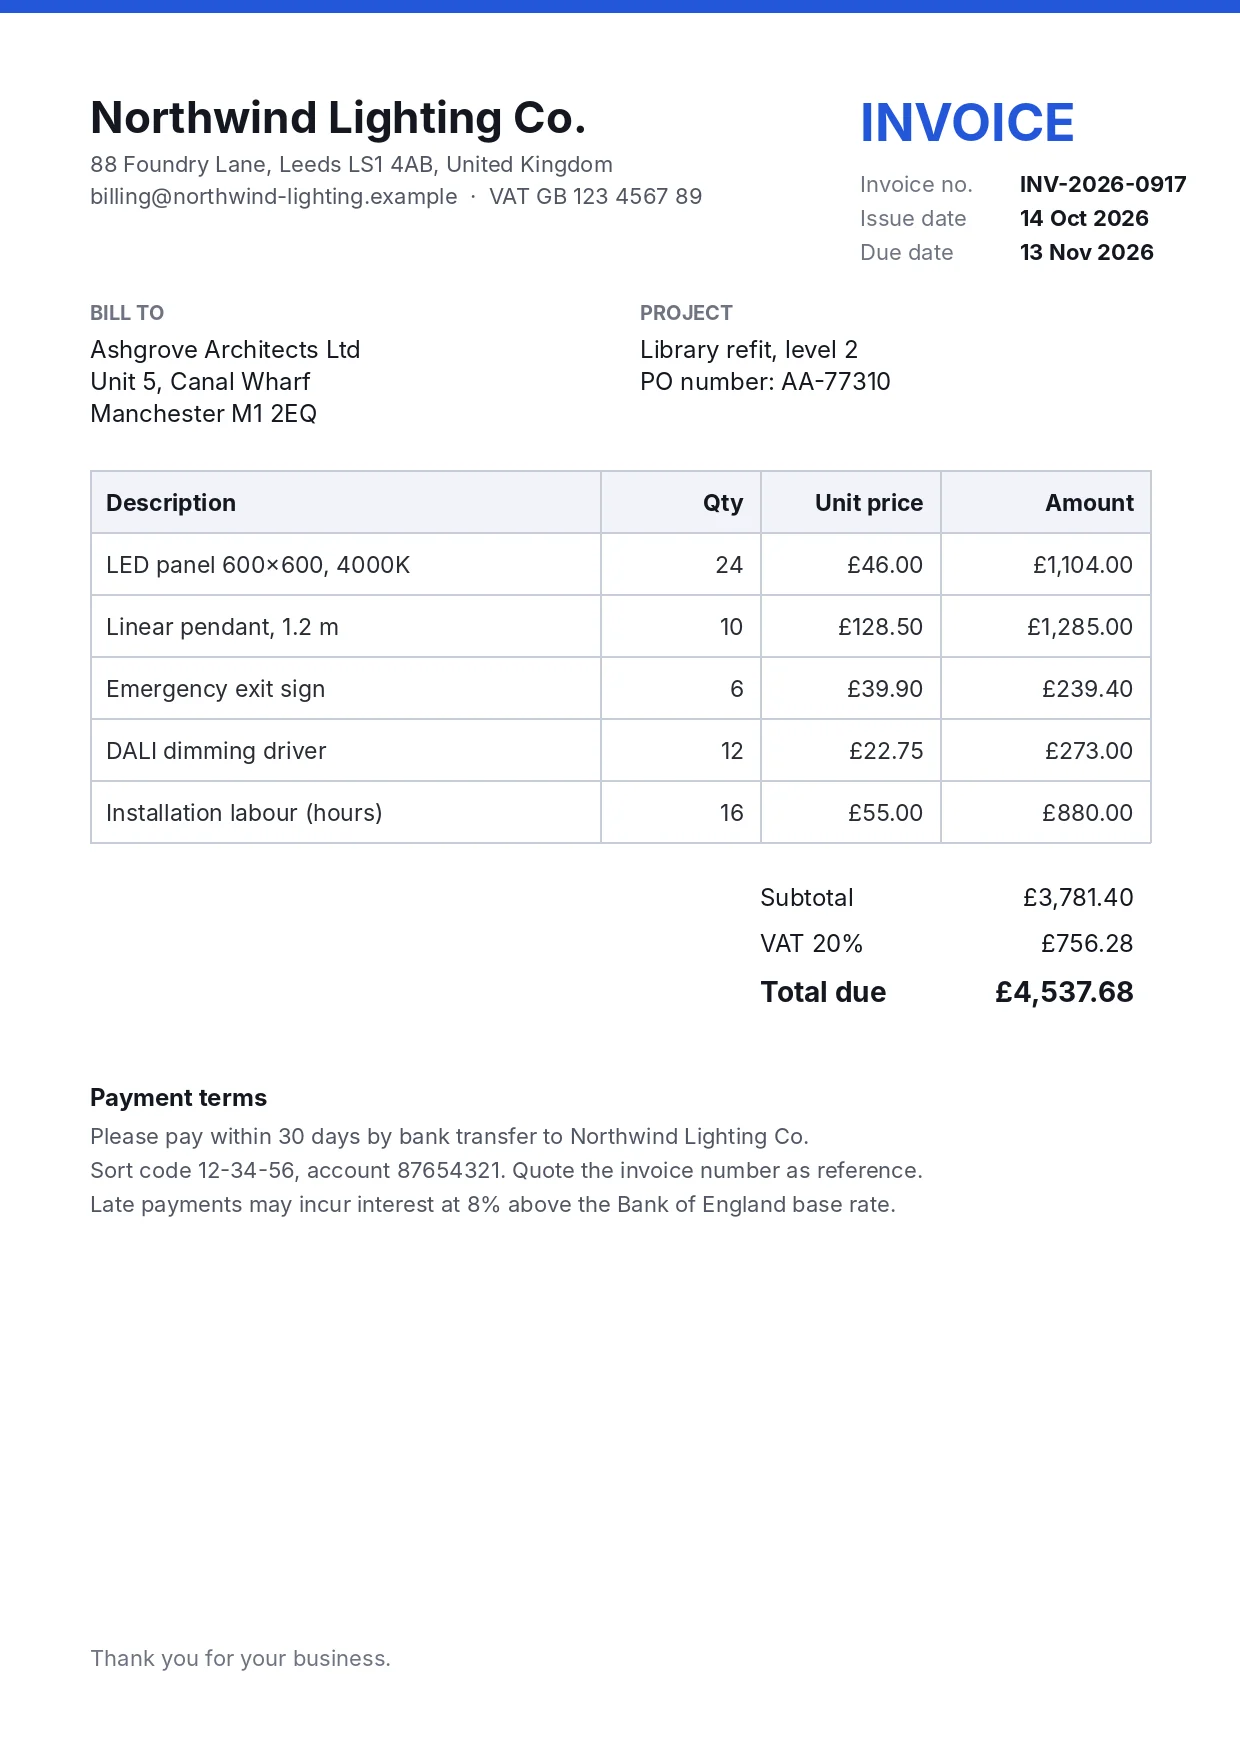
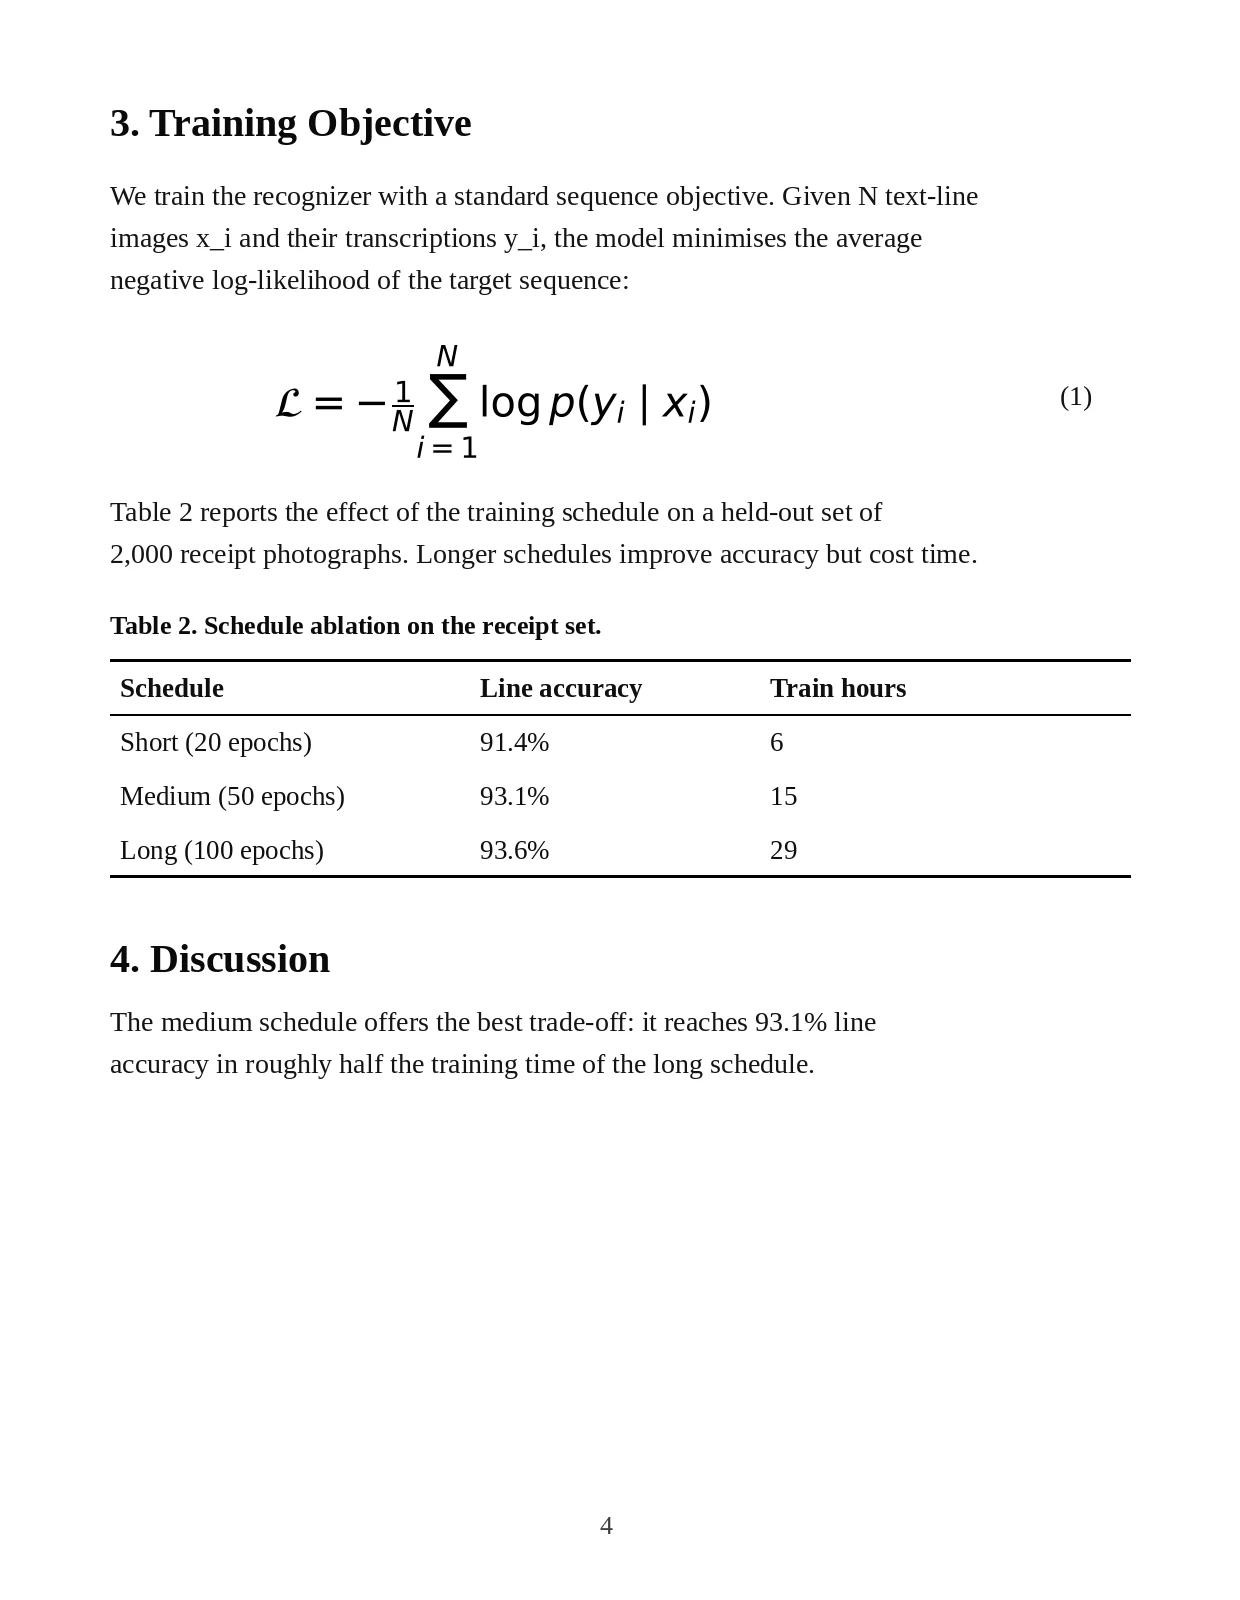
2 つのテストページに対して既定のパイプラインが出力した内容を、手を加えずにそのまま載せます。左が入力した画像、右が save_to_markdown() で書き出された .md ファイルです。4
請求書#
## Northwind Lighting Co

88 Foundry Lane, Leeds LS1 4AB, United Kingdom billing@northwind-lighting.example·VAT GB 123 4567 89INVOICE

Invoice no.INV-2026-0917Issue date 14 Oct 2026Due date 13 Noy 2026

BILL TO

Ashgrove Architects Ltd Unit 5. CanaL Wharf Manchester M1 2EQ

PROJECT

Library refit, Ievel 2PO number: AA-77310


<div style="text-align: center;"><html><body><table border="1"><tbody><tr><td>Description</td><td>Qty</td><td>Unit price</td><td>Amount</td></tr><tr><td>LED panel 600×600,4000K</td><td>24</td><td>£46.00</td><td>£1,104.00</td></tr><tr><td>Linear pendant, 1.2 m</td><td>10</td><td>£128.50</td><td>£1,285.00</td></tr><tr><td>Emergency exit sign</td><td>6</td><td>£39.90</td><td>£239.40</td></tr><tr><td>DALI dimming driver</td><td>12</td><td>£22.75</td><td>£273.00</td></tr><tr><td>Installation labour (hours)</td><td>16</td><td>£55.00</td><td>£880.00</td></tr></tbody></table></body></html></div>


## Payment terms

Subtotal £3,781.40VAT 20%£756.28Total due £4,537.68Please pay within 30 days by bank transfer to Northwind Lighting Co.Sort code 12-34-56, account 87654321. Quote the invoice number as reference.Late payments may incur interest at 8% above the Bank of England base rate.
上の表の HTML をそのまま表示すると次のようになります。
| Description | Qty | Unit price | Amount |
| LED panel 600×600,4000K | 24 | £46.00 | £1,104.00 |
| Linear pendant, 1.2 m | 10 | £128.50 | £1,285.00 |
| Emergency exit sign | 6 | £39.90 | £239.40 |
| DALI dimming driver | 12 | £22.75 | £273.00 |
| Installation labour (hours) | 16 | £55.00 | £880.00 |
正しく読めたもの:表の 24 セルすべて、すべての数値と価格、2 つの見出し、支払条件の全行。うまくいかなかった点:
- 3 行で文字が間違っている。Nov が
Noy、level がIevel(大文字の I)、Unit 5, Canal がUnit 5. CanaLになりました。原因は PP-OCRv5 の文字認識モデルです。解決策はこちら。 - ブロック内の改行が、スペースなしで消える。"INV-2026-0917Issue date 14 Oct 2026Due date" は、ページ上では 3 行のラベルと値でした。キーと値のペアが必要なら、Markdown ではなく
overall_ocr_res(テキスト行ごとに 1 エントリ)を読んでください。 - 読み順が 1 か所ずれた。合計欄のブロックが "Payment terms" の見出しの後ろに置かれ、その下の段落とつながってしまいました。
- フッターが消えた。"Thank you for your business." は検出されており、JSON にはラベル
footerで入っています。しかしfooterは、header、number、footnote、aside_text、ヘッダー/フッター画像とともに、既定のmarkdown_ignore_labelsに含まれています。3 すべて残したい場合はmarkdown_ignore_labels=[]を渡します。 - 表には
<thead>がなく、ヘッダー行は普通の行として出力されました。見出しの末尾のピリオドも落ちています("Northwind Lighting Co")。
数式と表を含む論文のページ#
### 3. Training Objective

We train the recognizer with a standard sequence objective. Given N text-line images x_i and their transcriptions y_i, the model minimises the average negative log-likelihood of the target sequence:

$$\mathcal{L}=-\textstyle\frac{1}{N}{\sum_{i\:=\:1}^{N}}\mathsf{l o g}\:p(y_{i}\mid x_{i}),$$

Table 2 reports the effect of the training schedule on a held-out set of 2,000 receipt photographs. Longer schedules improve accuracy but cost time.

<div style="text-align: center;">Table 2. Schedule ablation on the receipt set.</div>


<div style="text-align: center;"><html><body><table border="1"><thead><tr><td>Schedule</td><td>Line accuracy</td><td>Train hours</td></tr></thead><tbody><tr><td>Short (20 epochs)</td><td>91.4%</td><td>6</td></tr><tr><td>Medium (50 epochs)</td><td>93.1%</td><td>15</td></tr><tr><td>Long (100 epochs)</td><td>93.6%</td><td>29</td></tr></tbody></table></body></html></div>


### 4. Discussion

The medium schedule offers the best trade-off : it reaches 93.1% line accuracy in roughly half the training time of the long schedule.
このページはほぼ完璧でした。本文の単語はすべて正しく、表も正確で、今回はきちんと <thead> が付いています。キャプションも独立したブロックとして残りました。数式は数学的に正しい LaTeX ですが、癖が 2 つあります。"log" が \mathsf{l o g} として出力されること(通常の \log ではなくサンセリフ体の "log" として表示されます)、そして式番号 "(1)" は formula_number として検出されたものの Markdown には現れないことです。ページ番号 "4" は意図的に除外されています(ラベル number)。番号付きの見出しは ### に、請求書の番号なしの見出しは ## になりました。
解決策:PP-OCRv6 のテキストモデルを使う#
PaddleOCR 3.7.0 は通常の OCR の既定を PP-OCRv6 にしましたが、PP-StructureV3 の設定は今も PP-OCRv5_server_det と PP-OCRv5_server_rec を読み込みます。3 ocr_version="PP-OCRv6" では切り替えられません。このクラスでは PP-OCRv3、v4、v5 しか受け付けないためです。2 代わりにモデル名を渡します。
from paddleocr import PPStructureV3

pipeline = PPStructureV3(
    text_detection_model_name="PP-OCRv6_medium_det",
    text_recognition_model_name="PP-OCRv6_medium_rec",
)同じマシンで、請求書を両方の構成で処理しました。違いが出た行は次のとおりです(これですべてです)。4
| 既定(PP-OCRv5_server) | PP-OCRv6_medium 使用時 | ページ上の表記 |
|---|---|---|
Due date 13 Noy 2026 | Due date 13 Nov 2026 | 13 Nov 2026 |
Library refit, Ievel 2 | Library refit, level 2 | Library refit, level 2 |
Unit 5. CanaL Wharf | Unit 5, Canal Wharf | Unit 5, Canal Wharf |
LED panel 600×600,4000K | LED panel 600×600, 4000K | LED panel 600×600, 4000K |
billing@…example·VAT GB | billing@…example· VAT GB | billing@…example · VAT GB |
4 つの誤字はすべて直り、抜けていたスペースも 2 か所戻りました。悪化した箇所はありません。誤りの原因は確かにテキストモデルです。私たちの通常 OCR のベンチマーク (EN) でも、PP-OCRv5_server 単体がこの請求書でまったく同じ Noy、CanaL、Ievel の誤りを出していました。Markdown のそれ以外の部分(表、見出し、読み順)は同一でした。変えたのはテキストモデルだけだからです。
PP-OCRv6 のテキストモデルに替えると、テキストの誤りもすべて直りました。PP-StructureV3、請求書ページ、ウォームラン、4-vCPU Xeon、CPU 上の PaddlePaddle 3.2.0。短いほど高速。
| テキストモデル | 秒 |
|---|---|
| 既定(PP-OCRv5_server) | 14.9 s |
| PP-OCRv6_medium det + rec | 13.4 s |
_src/data/bench/structure_v6.py。この高速化は、私たちの通常 OCR のベンチマーク (EN) の結果とも一致します。CPU では PP-OCRv6_medium のほうが PP-OCRv5_server より速く、しかも正確でした。さらに、PP-OCRv6 medium は 1 つのモデルで 50 言語(日本語とラテン文字の 46 言語を含む)を読み取れるため、既定の構成が苦手とする多言語混在の文書にも対応できます。8
その他の言語#
lang パラメータはテキストモデルを自動で選びますが、選ばれるのは PP-OCRv5 以前のモデルだけです。3.7.0 のソースでは、lang="en"、"ch"、"chinese_cht"、"japan" はいずれも PP-OCRv5_server_rec に対応します。"fr" や "de" などのラテン文字の言語は latin_PP-OCRv5_mobile_rec、韓国語・タイ語・ギリシャ語・東スラヴ語にはそれぞれ専用の PP-OCRv5 mobile モデルが割り当てられ、アラビア文字・キリル文字・デーヴァナーガリー文字は PP-OCRv3 のモデルにフォールバックします。2 モデル名を渡した場合、lang は警告付きで無視されます。すべてのコードは対応言語一覧をご覧ください。
複数ページの PDF を 1 つの Markdown ファイルにする#
PDF に対して predict() を呼ぶとページごとに 1 つの結果が返り、save_to_markdown() はページごとに 1 ファイルを書き出します。1 つのファイルにまとめるには、各ページの res.markdown を集めて concatenate_markdown_pages() で結合します。この関数は、段落がページの切れ目をまたいで続いているかどうかも判定します。12
from pathlib import Path
from paddleocr import PPStructureV3

pipeline = PPStructureV3()
pages = pipeline.predict("report.pdf")

markdown_list, images = [], []
for res in pages:
    markdown_list.append(res.markdown)
    images.append(res.markdown.get("markdown_images", {}))

merged = pipeline.concatenate_markdown_pages(markdown_list)
text = merged["markdown_texts"]          # merged is a MarkdownResult, not a str

out = Path("output"); out.mkdir(exist_ok=True)
(out / "report.md").write_text(text, encoding="utf-8")
for page_images in images:                       # figures and table crops
    for rel_path, img in page_images.items():
        (out / rel_path).parent.mkdir(parents=True, exist_ok=True)
        img.save(out / rel_path)
公式の PDF サンプルはクラッシュします。使い方ガイドでは、concatenate_markdown_pages() の戻り値を f.write(markdown_texts) でそのままファイルに書き込んでいます。1 PaddleOCR 3.7.0 と PaddleX 3.7.2 ではこの関数は MarkdownResult オブジェクトを返すため、TypeError: write() argument must be str, not MarkdownResult が発生しました(出力ファイルは空のまま)。上のスクリプトのように ["markdown_texts"] で取り出してください。34
2 ページの PDF で起きたこと#
同じ 2 枚のテスト画像を Pillow で PDF にまとめ(画像は JPEG として格納されます)、パイプラインに通しました。PaddleX は PDF のページをズーム 2.0 で画像化するため、請求書は元の 1240 × 1754 ではなく 1191 × 1684 px の画像になりました。34 この小さな違いが、目に見える影響を及ぼしました。
- 既定のモデルでは、単語間のスペースがほとんど消えた。"88FoundryLane,LeedsLS14AB,UnitedKingdom"、"Please pay within30days" のようになりました。ただし、PNG で実行したときの文字の誤りは消えました。
- PP-OCRv6 ではテキストはきれいだった。"88 Foundry Lane, Leeds LS1 4AB, United Kingdom" と正しく読めましたが、数字の並び 1 か所だけは例外でした("VAT GB 123456789")。
- どちらの構成でも合計欄のブロックが消えた。"Subtotal"、"VAT 20%"、"Total due" は OCR では認識されており
overall_ocr_resに入っていますが、どのレイアウト枠にも含まれなかったため、parsing_res_listにも Markdown にも届きませんでした。PNG での実行時も、このブロックのレイアウトスコアは 0.40 しかありませんでした。 - 2 ページ目の数式は PNG のときよりきれいに出力されました。
\mathsf{l o g}ではなく\log p(y_{i}\mid x_{i})です。
消えたブロックを戻す解決策は layout_threshold でした。PDF を predict(..., layout_threshold=0.3) で再実行すると、合計欄が Markdown に戻りました("Subtotal £3,781.40VAT 20%£756.28Total due £4,537.68")。ただしラベルが変わりました。0.3 では上部の 2 つの見出しのうち 1 つがタイトルとしてタグ付けされなくなり、余分な header ブロックが 1 つ現れました。0.2 ではどちらの見出しもタイトルになりませんでした。しきい値は必要な分だけ下げてください。4
一般的な教訓として、Markdown に何が入るかはレイアウト検出で決まり、レイアウト検出は解像度と圧縮の影響を受けやすいということです。新しい種類の文書を扱うときは、何ページかを OCR が見つけた全行を保持している overall_ocr_res と照らし合わせて確認してください。
表#
表認識は既定で有効です。分類器が各表を罫線あり(wired)か罫線なし(wireless)かを判定し、構造モデルとセルモデルが HTML として再構成します。ページ上のすべての表は table_res_list に入り、同じ HTML が Markdown にも埋め込まれます。1
for res in pipeline.predict("invoice.png"):
    for i, table in enumerate(res["table_res_list"]):
        html = table["pred_html"]          # "<html><body><table>..."
        cells = table["cell_box_list"]     # one box per cell, page coordinates
        print(i, len(cells), html[:80])
    res.save_to_html(save_path="output")   # one .html file per table
    res.save_to_xlsx(save_path="output")   # one .xlsx file per table
請求書では cell_box_list にセルごとに 1 つ、計 24 個の枠が入り、論文のページでは 12 個でした。各エントリには、表内の生の OCR 結果である table_ocr_pred も含まれます。4 表の挙動を変える predict() のオプションは次のとおりです。2
| パラメータ | 既定値 | 使う場面 |
|---|---|---|
use_table_orientation_classify | True | ページ上で表が 90°/180°/270° 回転している可能性がある場合。 |
use_ocr_results_with_table_cells | True | OCR 結果を予測したセル境界で分割して再認識し、セルをまたぐテキストが失われないようにします。 |
use_e2e_wired_table_rec_model | False | 罫線ありの表:セル検出器を使わず、構造モデルだけで処理します。 |
use_e2e_wireless_table_rec_model | True | 罫線なしの表は、既定ですでに構造モデルだけで処理されます。 |
use_wired_table_cells_trans_to_html | False | 罫線ありの表で、検出したセル枠から直接 HTML を組み立てます(整ったグリッドに向いています)。 |
use_wireless_table_cells_trans_to_html | False | 罫線なしの表で同じことを行います。 |
レイアウトが不要で表だけが必要なら、別パイプラインの table_recognition_v2(TableRecognitionPipelineV2)のほうが軽量です。
数式#
数式認識は既定で有効で、PP-FormulaNet_plus-L を使います。各数式は formula_res_list に rec_formula(LaTeX)として入り、Markdown には $$…$$ ブロックとして現れます。上の論文ページが実例です。14 L モデルは最も精度が高い一方、パイプラインの中で群を抜いて重い部分です。Baidu 自身の数値(Tesla T4 GPU / Xeon Gold 6271C CPU)は次のとおりです。1
| モデル | En-BLEU | Zh-BLEU | CPU ms(HP モード) | サイズ |
|---|---|---|---|---|
PP-FormulaNet_plus-L(既定) | 92.22 | 90.64 | 3125.58 | 698 MB |
PP-FormulaNet_plus-M | 91.45 | 89.76 | 1615.80 | 592 MB |
PP-FormulaNet_plus-S | 88.71 | 53.32 | 260.99 | 248 MB |
英語だけの文書を CPU で処理するなら、これらの数値では formula_recognition_model_name="PP-FormulaNet_plus-S" は数式 1 つあたり約 12 倍速く、英語の精度の低下はわずかです(中国語の精度は大きく下がります)。文書に数式がなければ、use_formula_recognition=False でこのモデルをまるごと省けます。このフラグは engine="onnxruntime" を使う場合にも必須です。数式モデルがまだ対応していないためです。1
印影とグラフ#
どちらも既定では無効です。use_seal_recognition=True にすると PP-OCRv4_server_seal_det が加わり、スタンプ上の曲がったテキストを読み取ります(中国の請求書や契約書によくあります)。専用の seal_det_* しきい値があり、結果は seal_res_list に入ります。1 use_chart_recognition=True にすると、棒グラフ・折れ線グラフ・円グラフを PP-Chart2Table で表に変換します。0.58B パラメータ、約 1.4 GB のモデルです。1 このモデルの品質に関する Baidu の数値は一貫していません。使い方ガイドでは "Model Score" が 75.98、3.1.0 のリリースノートでは RMS-F1 が 80.60% とされており、おそらく指標が異なります。どちらも私たちのテストには含めていません。モデルの大きさからすると、CPU ではグラフの処理は遅いと考えてください。
重要なパラメータ#
コンストラクタのパラメータはすべて既定値が None で、「PaddleX の設定を使う」という意味です。使い方ガイドには、それらが最終的にどの値になるかが載っていますが、一部の設定については PaddleOCR 3.7.0 が実際に読み込む設定の値が異なります。13
| パラメータ | ドキュメントの記載 | PaddleX 3.7.2 の設定 | 役割 |
|---|---|---|---|
text_det_limit_side_len | 960 | 736 | テキスト検出の入力サイズの目標値。 |
text_det_limit_type | max | min | 上限を長辺と短辺のどちらに適用するか。 |
text_det_unclip_ratio | 2.0 | 1.5 | 各テキスト枠をどれだけ広げるか。 |
layout_threshold | 0.5 | クラスごとに 0.3〜0.5 | レイアウトの信頼度のしきい値。float または {class_id: value} を指定できます。 |
text_det_thresh / text_det_box_thresh | 0.3 / 0.6 | 0.3 / 0.6 | テキストのピクセルスコアと枠スコアのしきい値。 |
layout_nms / layout_merge_bboxes_mode | True / large | — | レイアウト枠の重なりの扱い。 |
use_region_detection | True | True | 読み順のための段組/領域のグループ化。 |
format_block_content | False | False | JSON 内の各 block_content を Markdown 形式にする。 |
markdown_ignore_labels | number, footnote, header, header_image, footer, footer_image, aside_text | Markdown から除外されるブロック。 | |
優先されるのは設定のほうです。保存した JSON には実際に使われた設定が記録されており、overall_ocr_res.text_det_params は limit_side_len 736, limit_type "min", unclip_ratio 1.5, max_side_limit 4000 でした。ドキュメントの値ではなく設定の値です。4 ドキュメントに従って PP-StructureV3 を調整したのに変化がなかったなら、これが理由です。
エンジンのオプションもキーワード引数で渡します。device、engine、enable_mkldnn(既定値 True)、cpu_threads(既定値 10)、enable_hpi、use_tensorrt、precision、そして YAML 全体を上書きする paddlex_config です。1
結果に含まれるもの#
ページごとの結果は辞書のように扱えるオブジェクトです。JSON ファイルにも同じフィールドが入っています。14
| フィールド | 内容 |
|---|---|
parsing_res_list | 読み順に並んだブロック:block_label(text、paragraph_title、table、formula、figure_title、footer…)、block_content、block_bbox、block_id、block_order。除外ラベルのブロックは block_order: null になります。 |
layout_det_res | ラベルとスコア付きの、生のレイアウト枠。 |
overall_ocr_res | すべてのテキスト行:rec_texts、rec_scores、rec_polys、rec_boxes、および text_det_params。請求書では 52 行でした。 |
table_res_list | 表ごとの pred_html、cell_box_list、table_ocr_pred。 |
formula_res_list | rec_formula(LaTeX)、rec_polys、formula_region_id。 |
seal_res_list | 印影のテキスト(有効にした場合)。 |
model_settings、width、height、page_index、page_count | 実行時の設定とページ情報(画像の場合 page_index は None)。 |
res.markdown は markdown_texts、markdown_images、page_continuation_flags、page_index、input_path を持つ辞書です。res.img では可視化画像(layout_det_res、overall_ocr_res など)が得られます。1
保存:Markdown、JSON、Word、HTML、Excel#
結果に対してすべての保存メソッドを呼び出してみました。6 つはそのまま動き、1 つは追加のパッケージが必要でした。4
| メソッド | 出力 | 私たちの結果 |
|---|---|---|
save_to_markdown(path) | {name}.md と、表・数式・図の切り出し画像を入れた imgs/ フォルダー | 成功 |
save_to_json(path) | 上記のすべてのフィールドを含む {name}_res.json | 成功 |
save_to_img(path) | レイアウト、OCR、読み順のオーバーレイ画像 | 成功 |
save_to_html(path) | 表ごとに 1 つの {name}_table_1.html | 成功 |
save_to_xlsx(path) | 表ごとに 1 つの {name}_table_1.xlsx | 成功 |
save_to_word(path) | {name}.docx(PaddleOCR 3.5.0 で追加) | python-docx を入れるまで失敗 |
save_to_latex(path) | {name}.tex(使い方ガイドには記載なし) | 成功 |
PDF を入力した場合、ファイル名にはページ番号が付きます(report_0.md、report_1.md など)。save_path にはファイル名ではなくディレクトリを渡してください。そうしないとページ同士が上書きされます。1
save_to_word() には python-docx が必要ですが、[doc-parser] ではインストールされません。ドキュメントどおりの extra だけでは ModuleNotFoundError: No module named 'docx' になりました。公式のクイックスタートの例が save_to_word() を呼んでいるにもかかわらずです。1 pip install python-docx の後は、問題なく .docx が書き出されました。(trans extra と PaddleX の base extra には python-docx が含まれますが、doc-parser には含まれません。)3
結果には save_all(path) もあり、すべての保存メソッドを一度に実行します。CLI の --save_path がしているのと同じことで、そのため CLI も python-docx がないと失敗します。
CPU での性能#
ここに載せた結果はすべて、4-vCPU Intel Xeon @ 2.10 GHz、15 GB RAM、GPU なしの環境で、CPU 上の PaddlePaddle 3.2.0(既定の oneDNN による高速化あり)を使って計測しました。4
| 実行(ウォーム、初回呼び出し後) | 既定のモデル | PP-OCRv6 テキストモデル |
|---|---|---|
| 請求書、1240 × 1754 px | 14.9 s | 13.4 s |
| 論文のページ、1240 × 1600 px* | 15.2–16.5 s | 14.1–16.2 s |
| 2 ページの PDF(両ページ合計)* | — | 25.1 s |
*別のセッションで、ほかのジョブとマシンを共有しながら計測したため、目安として扱ってください。請求書の数値はクリーンな実行で得たものです。実行してわかった実用上のポイントは 3 つです。
- 最初の呼び出しは遅い。パイプラインの作成時に十数個のモデルを読み込み(初めての実行ではダウンロードも行います)、最初の
predict()でウォームアップが入ります。パイプラインは一度だけ作成し、すべてのファイルで使い回してください。 - RAM は約 5 GB を見込む。既定のパイプラインを読み込んで実行したとき、Python プロセスが保持していたメモリ(常駐メモリ)がこの量でした。4 GB のマシンでは厳しいでしょう。
- 機能をオフにするのが最も効く。Baidu 自身の表によると、L モデルによる数式認識が最も重い処理です(Baidu の CPU で数式 1 つあたり 3 秒超)。
use_formula_recognition=False、use_chart_recognition=False(既定でオフ)、S の数式モデルは、いずれも時間を短縮します。1
Baidu が公表している数値がずっと速いのは、GPU や大型のサーバー CPU を使っているからです。既定の構成について、280 枚の画像によるベンチマークでは 1 枚あたり A100 で 1.38 秒、A10 で 1.74 秒、T4 で 3.70 秒とされています。「軽量」構成では Intel Xeon 8350C CPU で 1 枚あたり 3.74 秒、Apple M4 で 12.22 秒です。6 これらは公式の数値で、私たちは再現していません。
| Baidu のローカルテスト(PDF 925 ページ) | V100 | A100 |
|---|---|---|
| サーバー版 OCR、FormulaNet-L、グラフなし、最大辺 4096 | 1.77 s/page | 1.12 s/page |
| 同上、グラフ認識あり | 4.09 s/page | 2.76 s/page |
| モバイル版 OCR、FormulaNet-M、グラフなし、最大辺 1200 | 0.99 s/page | 0.64 s/page |
同じ出典によると、グラフ認識を有効にするとページあたりの時間は 2 倍以上になり、モバイル版の軽い構成ではおよそ半分になります。GPU メモリのピークは、サーバー版モデルで V100 が 17.0 GB、A100 が 21.8 GB、軽い構成では 8.6 GB と 11.4 GB でした。6
PaddleOCR 2.x の PPStructure からの移行#
PPStructure は 3.x で削除され、from paddleocr import PPStructure は ImportError になります。後継は PPStructureV3 ですが、PaddleOCR クラスとは違って互換レイヤーがありません。旧来のキーワード引数はすべて ValueError: Unknown argument: … になります。9
| 2.x | 3.x |
|---|---|
PPStructure(use_gpu=True) | PPStructureV3(device="gpu:0")(または "cpu") |
PPStructure(show_log=False) | 廃止。Python の logging を使用 |
table=True / formula=True | use_table_recognition / use_formula_recognition(数式は既定で有効になった) |
image_orientation=True | use_doc_orientation_classify=True |
layout=False、ocr=False | 相当するものはなし。PaddleOCR または TableRecognitionPipelineV2 を使用 |
det_model_dir、rec_model_dir、use_angle_cls | text_detection_model_dir、text_recognition_model_dir、use_textline_orientation |
layout_score_threshold | layout_threshold |
recovery=True、convert_info_docx() | res.save_to_word() / res.save_to_markdown() |
save_structure_res()、to_excel() | res.save_to_json()、res.save_to_xlsx() |
engine(img) | pipeline.predict(img) |
mode='kie' | PP-ChatOCRv4(paddleocr[ie]) |
CLI --type structure --recovery true | paddleocr pp_structurev3 -i file --save_path out/ |
完全な対応表と、旧コードを書き換える変換ツールは移行ガイドにあります。
PP-StructureV3 を使うべきでない場合#
- テキストだけが必要。通常の PaddleOCR(PP-OCRv6)のほうが速く処理できます。私たちのマシンでは、この請求書を PP-OCRv6 medium が PaddlePaddle で 9.3 秒、ONNX Runtime で 5.7 秒、PP-OCRv6 small が 1.9 秒で読み取りました(ベンチマーク (EN))。すべての行を枠付きで返すので、帳票にはこちらのほうが向いていることがよくあります。
- 難しい文書での精度を最優先し、GPU がある。OmniDocBench v1.5(第三者)では、PP-StructureV3 の総合スコアは 86.73、PaddleOCR-VL-1.5 は 94.50 です。7 質の悪いスキャン、手書き、複雑なレイアウトには PaddleOCR-VL が向いています。
- 帳票とキー・値の抽出。請求書の例のとおり、Markdown ではラベルと値のペアが区切りのないテキストにつながってしまいます。行単位の OCR を使うか、PP-ChatOCRv4 のような抽出パイプラインを使ってください。
- デジタル生成の PDF。PDF にすでにテキストレイヤーがあるなら、そのテキストを直接取り出せば OCR の誤りはまったく生じず、時間もわずかで済みます。PP-StructureV3 はスキャンや画像だけの PDF に使いましょう。Word、Excel、PowerPoint のファイルは、PaddleOCR の
doc2mdで OCR なしに変換できます。 - 小さなマシン。既定のパイプラインは、698 MB の数式モデルを含む十数個のモデルを読み込みます。メモリの少ないサーバーでは、数式とグラフをオフにするか、軽量モデルを使ってください。
まだ迷っているなら、OCR ツール比較 (EN) で PP-StructureV3 を Docling、MinerU などと比べています。
よくある質問#
PP-StructureV3 はどうやってインポートしますか?
from paddleocr import PPStructureV3 です。大文字と V3 に注意してください。pip install "paddleocr[doc-parser]" が必要で、この extra がないと "A dependency error occurred during pipeline creation" になります。
PP-StructureV3 に GPU は必要ですか?
いいえ。GPU なしの 4-vCPU Xeon で、1 ページあたり約 13〜15 秒で動きました。大量に処理するなら GPU が役立ちます。Baidu は既定の構成で A100 の場合 1 枚あたり 1.38 秒と報告しています。
PaddleOCR で PDF を Markdown に変換するには?
PPStructureV3().predict("file.pdf") を実行し、各ページの res.markdown を集めて、そのリストを pipeline.concatenate_markdown_pages() に渡します。上の完全なスクリプトは、Markdown が参照する画像も保存します。
PPStructure(use_gpu=True) がエラーになるのはなぜですか?
PPStructure は PaddleOCR 3.x で削除され、use_gpu もどこにも存在しなくなりました。PPStructureV3(device="gpu:0") を使ってください。2.x のキーワード名は PPStructureV3 ではすべて "Unknown argument" になります。対応表をご覧ください。
表を Excel や HTML で取り出すには?
res.save_to_xlsx("output") または res.save_to_html("output") を呼ぶか、res["table_res_list"][i]["pred_html"] を直接読みます。同じ HTML が Markdown にも埋め込まれています。
Markdown に一部のテキストが入らないのはなぜですか?
ヘッダー、フッター、ページ番号、脚注、傍注は、markdown_ignore_labels により既定で除外されます。JSON には残っています。含めたい場合は markdown_ignore_labels=[] を渡してください。
PP-StructureV3 と PaddleOCR-VL のどちらを選ぶべきですか?
CPU で使う場合、表のセルや行の座標が必要な場合、各ステップを小さく交換可能なモデルにしたい場合は PP-StructureV3 です。GPU があって最高の精度が欲しいなら PaddleOCR-VL です。OmniDocBench v1.5 では、PP-StructureV3 の 86.73 に対して 94.50 を記録しています。
PP-StructureV3 の中で PP-OCRv6 を使えますか?
はい、おすすめです。text_detection_model_name="PP-OCRv6_medium_det" と text_recognition_model_name="PP-OCRv6_medium_rec" を渡してください。ocr_version="PP-OCRv6" は使えません。このクラスでは、このパラメータは PP-OCRv5 までです。
出典
- PP-StructureV3 の使い方ガイド:docs/version3.x/pipeline_usage/PP-StructureV3.en.md(リポジトリのコミット dab3fe3、2026-09-16):モジュール(9〜19 行目)、モデル表(83〜891)、テスト環境(917〜926)、CLI と Python(963〜1781)、パラメータの既定値(1803〜2470)、結果のフィールドとメソッド(2771〜2992)。
- PaddleOCR 3.7.0 のパッケージソース(PyPI の wheel)、
paddleocr/_pipelines/pp_structurev3.py:__init__のパラメータ(32〜101)、PP-OCRv3〜v5 に限られるocr_version(28、103〜106)、lang→ モデルの対応(530〜660)、predictの既定値(148〜185)、concatenate_markdown_pages(300〜301)、CLI サブコマンド(696)。paddleocr.dev が 2026-10-27 に確認。 - PaddleX 3.7.2 の wheel(PyPI、2026-06-25)、
paddlex/configs/pipelines/PP-StructureV3.yaml:既定のモデル(25〜233 行目)、スイッチとmarkdown_ignore_labels(4〜20)、テキスト検出の設定(112〜117)、クラスごとのレイアウトしきい値(28〜48)。あわせてinference/pipelines/layout_parsing/pipeline_v2.py:1323-1378(concatenate_markdown_pagesはMarkdownResultを返す)とinference/common/result/mixin.py:69-84(save_to_word)。 - paddleocr.dev のテスト、2026-10-27:Linux x86-64、4 vCPU Intel Xeon @ 2.10 GHz、15 GB RAM、GPU なし、Python 3.13、paddlepaddle 3.2.0、paddleocr 3.7.0、paddlex 3.7.2。スクリプトと生の出力(Markdown + JSON)は
_src/data/bench/structure/、サンプル画像は /assets/samples/invoice.webp と /assets/samples/paper-page.webp。 - PaddleOCR の README.md:PP-StructureV3 の位置づけとセル単位の座標(41 行目)、2026-04-21 の 3.5.0 で追加された DOCX 出力(97、101)。3.0 のリリースは 2025-05-20(
docs/update/update.en.md:128,134)。 - PP-StructureV3 のアルゴリズム文書、
docs/version3.x/algorithm/PP-StructureV3/PP-StructureV3.en.md:ローカルの速度テスト(305〜921)、サービングのテスト(922〜950)、280 枚の画像によるパイプラインのベンチマーク(952〜1497)、CPU に関する FAQ の "about 3.74 seconds"(1518)。いずれも公式(Baidu)の数値。 - OmniDocBench の README、
v1_5ブランチ(opendatalab/OmniDocBench):PP-StructureV3 の総合スコア 86.73、806〜817 行目。第三者の数値。 - PP-OCRv6 の対応言語、
docs/version3.x/algorithm/PP-OCRv6/PP-OCRv6.en.md:3:medium と small は 1 つのモデルで 50 言語を読み取る。 - 2.x → 3.x のパラメータ対応:
paddleocr/_common_args.py:52-54("Unknown argument")、docs/update/upgrade_notes.en.md:73、paddleocr 2.10.0 のppstructure/utility.py、CLI の--save_pathの挙動はpaddleocr/_utils/cli.py:41-45,68-73。私たちの移行ガイドにまとめています。