本页目录
简短回答:先 pip install "paddleocr[doc-parser]",然后 PPStructureV3().predict("file.pdf"),再对每一页调用 save_to_markdown()。表格输出为 HTML,公式输出为 LaTeX。在我们的 4 核 CPU 上,每页约 13–15 秒。有一个值得知道的技巧:3.7 版的产线仍然用 PP-OCRv5 模型识别文字——改传 PP-OCRv6 模型后,我们发票上的文字错误全部消失,而且速度更快。
PP-StructureV3 能做什么#
PP-StructureV3 随 PaddleOCR 3.0 于 2025 年 5 月发布,是在之前的版面解析产线基础上构建的。它带来了更好的版面、表格和公式模型,以及图表理解、多栏阅读顺序和 Markdown 输出。15它由大约十几个小模型串联而成,每个模型都由一个 use_* 开关控制启用与否:
下面是 PaddleOCR 3.7.0 实际加载的默认模型。它们写在 PaddleX 3.7.2 的产线配置里,而不是 PaddleOCR 自己的文档里,所以其中有几项会让人意外:3
| 任务 | 默认模型 | 默认开启? | 开关 |
|---|---|---|---|
| 版面检测 | PP-DocLayout_plus-L | 始终开启 | — |
| 区域(分栏)检测 | PP-DocBlockLayout | 是 | use_region_detection |
| 文本检测 / 识别 | PP-OCRv5_server_det / PP-OCRv5_server_rec | 始终开启 | — |
| 表格 | PP-LCNet_x1_0_table_cls 判断有线表还是无线表;SLANeXt_wired / SLANet_plus 识别结构;RT-DETR-L 单元格检测模型 | 是 | use_table_recognition |
| 公式 | PP-FormulaNet_plus-L | 是 | use_formula_recognition |
| 印章 | PP-OCRv4_server_seal_det | 否 | use_seal_recognition |
| 图表 → 表格 | PP-Chart2Table(0.58B 参数) | 否 | use_chart_recognition |
| 整页方向 / 弯曲矫正 | PP-LCNet_x1_0_doc_ori / UVDoc | 否 | use_doc_orientation_classify、use_doc_unwarping |
| 文本行方向 | PP-LCNet_x1_0_textline_ori | 否 | use_textline_orientation |
有两点需要注意。使用文档里写的无线表(无边框表格)模型是 SLANeXt_wireless,但配置实际加载的是 SLANet_plus。13另外,PP-StructureV3 不使用 PP-DocLayoutV2/V3——它们属于 PaddleOCR-VL。两者的取舍在于:PP-StructureV3 能给出单元格级和文本行级的坐标,而 VL 系列不能。5
安装#
PP-StructureV3 除了 PaddleOCR 和推理引擎之外,还需要 doc-parser 这个 extra。以下是我们使用的命令:4
python -m pip install paddlepaddle==3.2.0
python -m pip install "paddleocr[doc-parser]==3.7.0" python-docx
python -m pip install paddlepaddle-gpu==3.2.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/
python -m pip install "paddleocr[doc-parser]==3.7.0" python-docx这个 extra 会装上 paddlex[ocr,genai-client]——包括 BeautifulSoup、lxml、openpyxl、pypdfium2、scikit-learn、tokenizers 等。它要求 Python 3.9 或更高版本。我们额外安装 python-docx,因为这个 extra 不包含它,而缺了它 Word 导出——以及命令行的 --save_path——都会失败(详情)。我们锁定 paddlepaddle==3.2.0,是因为 PyPI 上当前的 3.3.1 版在我们的测试中会让 PaddleOCR 3.7.0 在 CPU 上崩溃(详情与修复方法)。
不装这个 extra,创建产线时就会失败。这是我们复现出的报错:
RuntimeError: A dependency error occurred during pipeline creation. Please refer to the installation documentation to ensure all required dependencies are installed.
(caused by DependencyError: `PP-StructureV3` requires additional dependencies. To install them, run `pip install "paddlex[ocr]==<PADDLEX_VERSION>"` if you're installing `paddlex` from an index, ...)
修复方法是 pip install "paddleocr[doc-parser]"——报错信息建议直接安装 paddlex[ocr],这样也行,但很容易与 PaddleOCR 锁定的版本对不上。
快速开始:Python 与命令行#
from paddleocr import PPStructureV3

pipeline = PPStructureV3(
    use_doc_orientation_classify=False,   # 本来就是默认值;旋转的扫描件请设为 True
    use_doc_unwarping=False,              # 拍摄的弯曲页面请设为 True
)
for res in pipeline.predict("invoice.png"):
    res.print()                                  # 在终端打印结构化结果
    res.save_to_markdown(save_path="output")     # output/invoice.md + output/imgs/
    res.save_to_json(save_path="output")         # output/invoice_res.json
    res.save_to_img(save_path="output")          # 版面、OCR 和阅读顺序的可视化图
paddleocr pp_structurev3 -i invoice.png --save_path ./output
# GPU,以及最常用的几个开关
paddleocr pp_structurev3 -i scan.pdf --device gpu:0 \
--use_doc_orientation_classify True --use_chart_recognition True --save_path ./output第一次运行会把所有默认模型下载到 ~/.paddlex/official_models/。在命令行中,--save_path 会对每一页调用所有已注册的保存方法,包括 Word 导出——所以没装 python-docx 时,我们的命令行运行写出了 Markdown、JSON、HTML、XLSX 和图片,然后以 ModuleNotFoundError: No module named 'docx' 和退出码 1 中止。94设备会自动选择(有 GPU 时用 GPU 0);传入 device="cpu" 或 device="gpu:0" 可以强制指定。
真实输出:一张发票和一页论文#
下面是默认产线在我们两张测试页面上的原始输出,未做任何修改。左边是输入的图片,右边是 save_to_markdown() 生成的 .md 文件。4
发票#
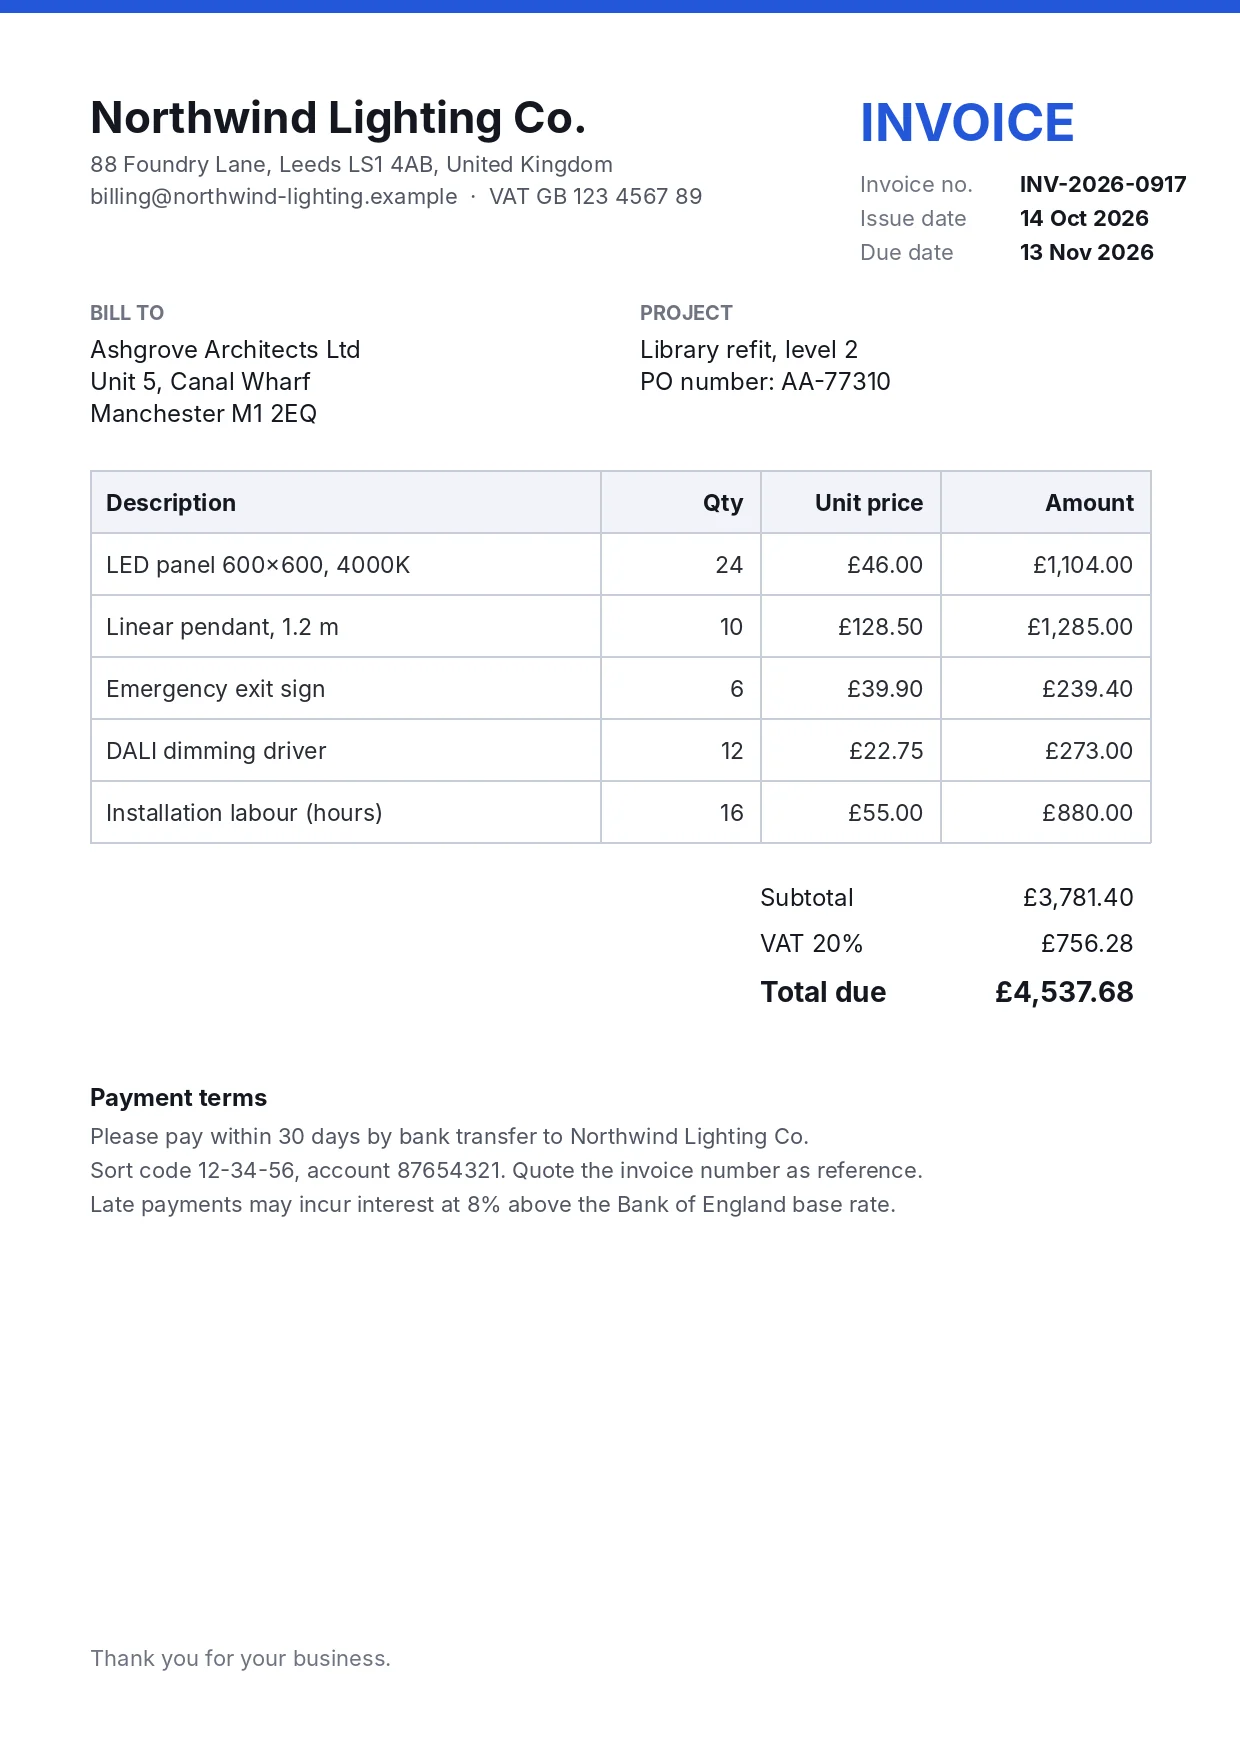
## Northwind Lighting Co

88 Foundry Lane, Leeds LS1 4AB, United Kingdom billing@northwind-lighting.example·VAT GB 123 4567 89INVOICE

Invoice no.INV-2026-0917Issue date 14 Oct 2026Due date 13 Noy 2026

BILL TO

Ashgrove Architects Ltd Unit 5. CanaL Wharf Manchester M1 2EQ

PROJECT

Library refit, Ievel 2PO number: AA-77310


<div style="text-align: center;"><html><body><table border="1"><tbody><tr><td>Description</td><td>Qty</td><td>Unit price</td><td>Amount</td></tr><tr><td>LED panel 600×600,4000K</td><td>24</td><td>£46.00</td><td>£1,104.00</td></tr><tr><td>Linear pendant, 1.2 m</td><td>10</td><td>£128.50</td><td>£1,285.00</td></tr><tr><td>Emergency exit sign</td><td>6</td><td>£39.90</td><td>£239.40</td></tr><tr><td>DALI dimming driver</td><td>12</td><td>£22.75</td><td>£273.00</td></tr><tr><td>Installation labour (hours)</td><td>16</td><td>£55.00</td><td>£880.00</td></tr></tbody></table></body></html></div>


## Payment terms

Subtotal £3,781.40VAT 20%£756.28Total due £4,537.68Please pay within 30 days by bank transfer to Northwind Lighting Co.Sort code 12-34-56, account 87654321. Quote the invoice number as reference.Late payments may incur interest at 8% above the Bank of England base rate.
上面的表格 HTML 原样渲染后如下:
| Description | Qty | Unit price | Amount |
| LED panel 600×600,4000K | 24 | £46.00 | £1,104.00 |
| Linear pendant, 1.2 m | 10 | £128.50 | £1,285.00 |
| Emergency exit sign | 6 | £39.90 | £239.40 |
| DALI dimming driver | 12 | £22.75 | £273.00 |
| Installation labour (hours) | 16 | £55.00 | £880.00 |
做对了的:全部 24 个表格单元格、每个数字和价格、两个章节标题,以及付款条款的每一行。出错的地方:
- 三行文字有错字:
Noy应为 Nov,Ievel(大写 I)应为 level,Unit 5. CanaL应为 Unit 5, Canal。这些错误来自 PP-OCRv5 文本识别模型——见修复方法。 - 区块内的换行直接消失,连空格都没留。“INV-2026-0917Issue date 14 Oct 2026Due date”在页面上原本是三行“标签/值”。如果你需要键值对,请读取
overall_ocr_res(每个文本行一条),而不是 Markdown。 - 阅读顺序错了一次。合计金额区块被放到了“Payment terms”标题之后,并和下面的段落粘在一起。
- 页脚不见了。“Thank you for your business.”其实被检测到了——它在 JSON 里,标签为
footer——但footer属于默认的markdown_ignore_labels,同在其中的还有 header、number、footnote、aside_text 以及页眉/页脚图片。3传入markdown_ignore_labels=[]即可保留全部内容。 - 表格没有
<thead>,表头行只是一个普通行。标题丢掉了末尾的句点(“Northwind Lighting Co”)。
含公式和表格的论文页#
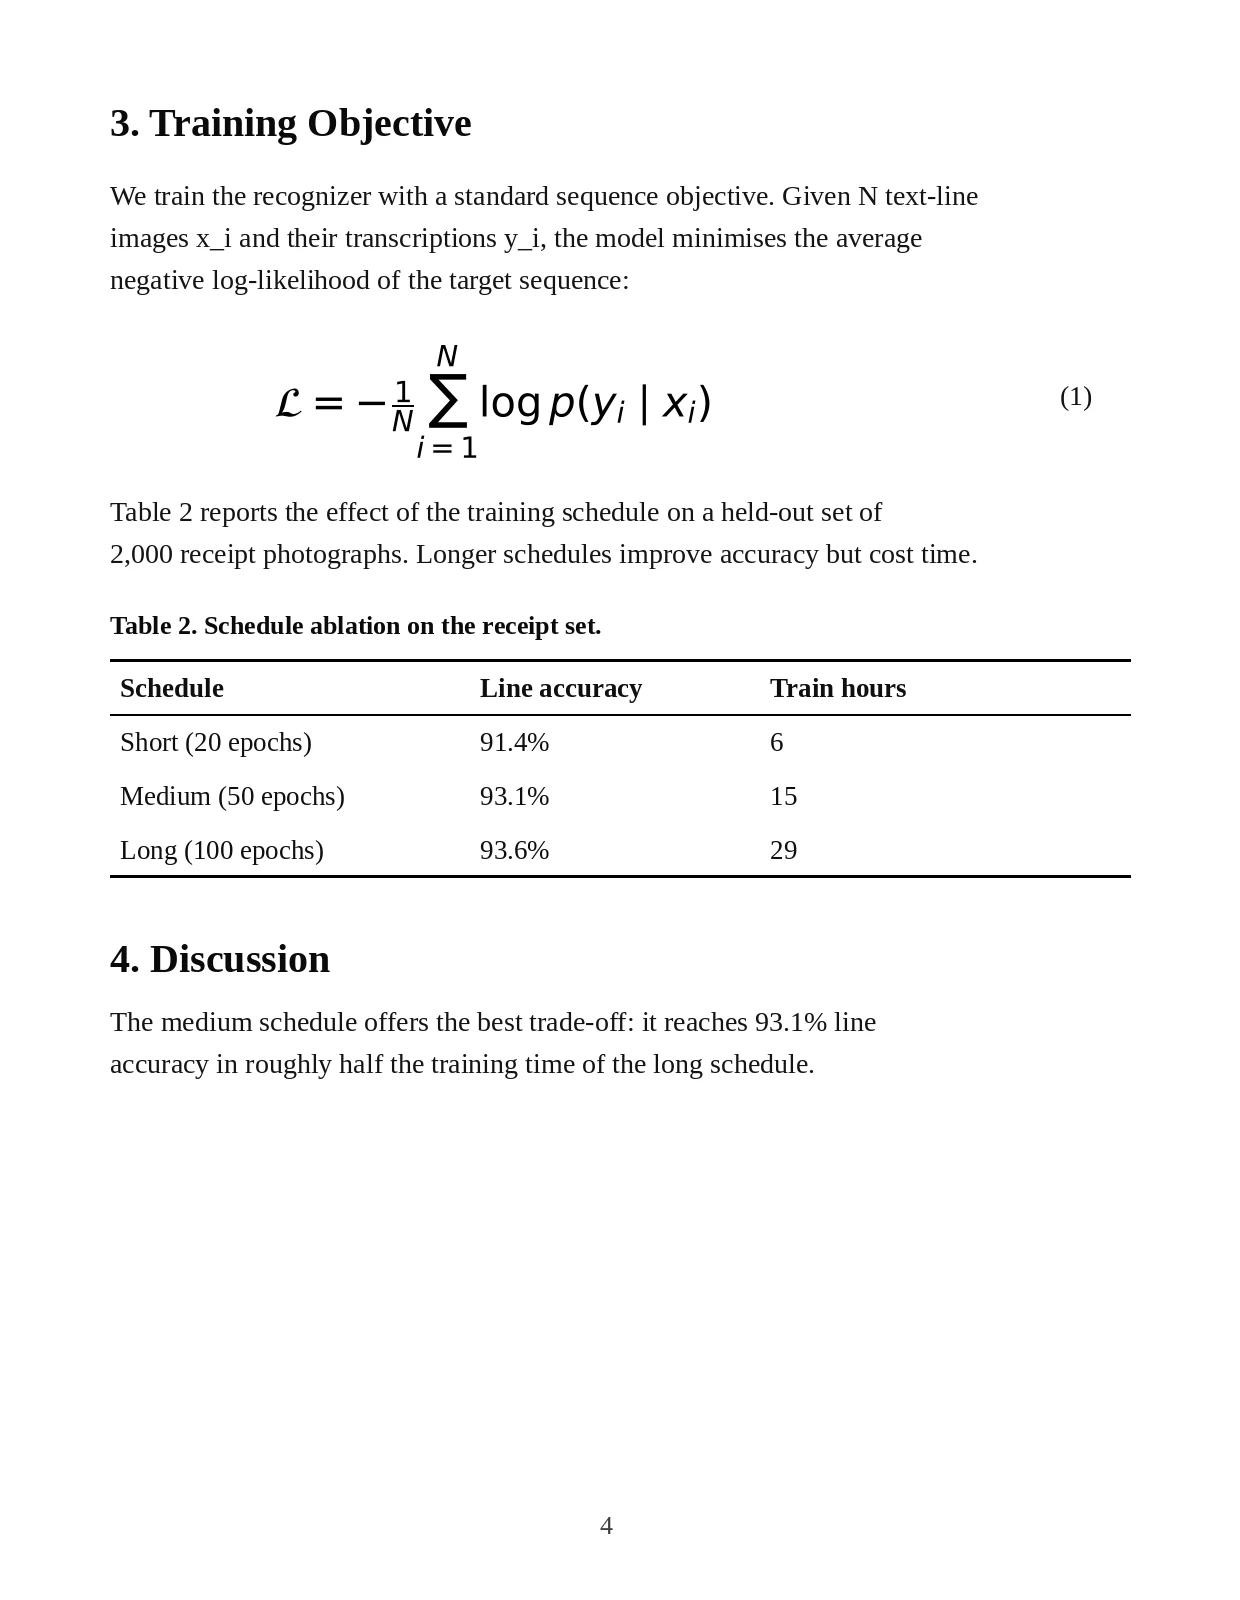
### 3. Training Objective

We train the recognizer with a standard sequence objective. Given N text-line images x_i and their transcriptions y_i, the model minimises the average negative log-likelihood of the target sequence:

$$\mathcal{L}=-\textstyle\frac{1}{N}{\sum_{i\:=\:1}^{N}}\mathsf{l o g}\:p(y_{i}\mid x_{i}),$$

Table 2 reports the effect of the training schedule on a held-out set of 2,000 receipt photographs. Longer schedules improve accuracy but cost time.

<div style="text-align: center;">Table 2. Schedule ablation on the receipt set.</div>


<div style="text-align: center;"><html><body><table border="1"><thead><tr><td>Schedule</td><td>Line accuracy</td><td>Train hours</td></tr></thead><tbody><tr><td>Short (20 epochs)</td><td>91.4%</td><td>6</td></tr><tr><td>Medium (50 epochs)</td><td>93.1%</td><td>15</td></tr><tr><td>Long (100 epochs)</td><td>93.6%</td><td>29</td></tr></tbody></table></body></html></div>


### 4. Discussion

The medium schedule offers the best trade-off : it reaches 93.1% line accuracy in roughly half the training time of the long schedule.
这一页的结果几乎完美。正文每个词都正确;表格完全准确,这次还有了正确的 <thead>;图表标题也作为独立区块保留了下来。公式是数学上正确的 LaTeX,但有两处小问题:“log”被输出为 \mathsf{l o g}(渲染成无衬线的“log”,而不是常见的 \log);公式编号“(1)”被检测为 formula_number,但没有出现在 Markdown 中。页码“4”是被有意去掉的(标签为 number)。带编号的标题变成了 ###;发票上不带编号的标题则变成了 ##。
修复:改用 PP-OCRv6 文本模型#
PaddleOCR 3.7.0 已把 PP-OCRv6 设为普通 OCR 的默认模型,但 PP-StructureV3 的配置仍然加载 PP-OCRv5_server_det 和 PP-OCRv5_server_rec。3你无法通过 ocr_version="PP-OCRv6" 切换——这个类在该参数上只接受 PP-OCRv3、v4 和 v5。2请直接传入模型名称:
from paddleocr import PPStructureV3

pipeline = PPStructureV3(
    text_detection_model_name="PP-OCRv6_medium_det",
    text_recognition_model_name="PP-OCRv6_medium_rec",
)我们在同一台机器上用两种配置分别处理了这张发票。所有不同的行如下:4
| 默认(PP-OCRv5_server) | 使用 PP-OCRv6_medium | 页面上的原文 |
|---|---|---|
Due date 13 Noy 2026 | Due date 13 Nov 2026 | 13 Nov 2026 |
Library refit, Ievel 2 | Library refit, level 2 | Library refit, level 2 |
Unit 5. CanaL Wharf | Unit 5, Canal Wharf | Unit 5, Canal Wharf |
LED panel 600×600,4000K | LED panel 600×600, 4000K | LED panel 600×600, 4000K |
billing@…example·VAT GB | billing@…example· VAT GB | billing@…example · VAT GB |
四个错字全部修正,还补回了两个缺失的空格,没有任何地方变差。这些错误确实来自文本模型:在我们的 普通 OCR 基准测试(英文) 中,单独运行的 PP-OCRv5_server 在这张发票上犯了完全相同的 Noy、CanaL 和 Ievel 错误。Markdown 的其余部分——表格、标题、阅读顺序——完全一致,因为只换了文本模型。
换用 PP-OCRv6 文本模型还修正了所有文字错误。PP-StructureV3,发票页,热启动运行,4-vCPU Xeon,CPU 上的 PaddlePaddle 3.2.0。越低越快。
| 文本模型 | 秒 |
|---|---|
| 默认(PP-OCRv5_server) | 14.9 s |
| PP-OCRv6_medium det + rec | 13.4 s |
_src/data/bench/structure_v6.py。这个提速与我们的 普通 OCR 基准测试(英文) 一致:在 CPU 上,PP-OCRv6_medium 比 PP-OCRv5_server 更快也更准。另一个好处是:PP-OCRv6 medium 用一个模型就能识别 50 种语言,包括日文和 46 种拉丁字母语言,因此对默认模型处理得不太好的多语言混排文档也能覆盖。8
其他语言#
lang 参数会替你选择文本模型,但只会从 PP-OCRv5 及更早的模型中选。在 3.7.0 源码中,lang="en"、"ch"、"chinese_cht" 和 "japan" 都映射到 PP-OCRv5_server_rec;"fr"、"de" 等拉丁字母语言使用 latin_PP-OCRv5_mobile_rec;韩文、泰文、希腊文和东斯拉夫语言有各自的 PP-OCRv5 mobile 模型;阿拉伯文、西里尔文和天城文则退回到 PP-OCRv3 模型。2如果你传入了模型名称,lang 会被忽略并给出警告。全部语言代码见 语言列表。
多页 PDF 转为一个 Markdown 文件#
对 PDF 调用 predict() 会为每一页返回一个结果,save_to_markdown() 也是每页写一个文件。要得到单个文件,请收集每页的 res.markdown,再用 concatenate_markdown_pages() 合并,它还会判断段落是否跨页延续:12
from pathlib import Path
from paddleocr import PPStructureV3

pipeline = PPStructureV3()
pages = pipeline.predict("report.pdf")

markdown_list, images = [], []
for res in pages:
    markdown_list.append(res.markdown)
    images.append(res.markdown.get("markdown_images", {}))

merged = pipeline.concatenate_markdown_pages(markdown_list)
text = merged["markdown_texts"]          # merged 是 MarkdownResult,不是 str

out = Path("output"); out.mkdir(exist_ok=True)
(out / "report.md").write_text(text, encoding="utf-8")
for page_images in images:                       # 图片和表格截图
    for rel_path, img in page_images.items():
        (out / rel_path).parent.mkdir(parents=True, exist_ok=True)
img.save(out / rel_path)我们的 2 页 PDF 测试结果#
我们用 Pillow 把同样的两张测试图片打包成 PDF(Pillow 会把它们存为 JPEG),再交给产线处理。PaddleX 以 2.0 倍缩放渲染 PDF 页面,所以发票变成了 1191 × 1684 px 的图片,而不是原来的 1240 × 1754。34这个小变化带来了明显的影响:
- 默认模型丢掉了大部分词间空格:“88FoundryLane,LeedsLS14AB,UnitedKingdom”、“Please pay within30days”。不过 PNG 运行中的字符错误消失了。
- 使用 PP-OCRv6 时文字是干净的——“88 Foundry Lane, Leeds LS1 4AB, United Kingdom”——只有一串数字例外(“VAT GB 123456789”)。
- 两种配置下合计金额区块都消失了。“Subtotal”、“VAT 20%”和“Total due”都被 OCR 识别出来了——它们在
overall_ocr_res里——但没有任何版面框覆盖它们,所以它们没能进入parsing_res_list和 Markdown。在 PNG 运行中,该区块的版面得分只有 0.40。 - 第 2 页的公式比 PNG 版本更干净:是
\log p(y_{i}\mid x_{i}),而不是\mathsf{l o g}。
区块缺失的修复方法是 layout_threshold。用 predict(..., layout_threshold=0.3) 重新处理 PDF 后,合计金额回到了 Markdown 中(“Subtotal £3,781.40VAT 20%£756.28Total due £4,537.68”)。不过标签也有变化:在 0.3 时,顶部两个标题之一不再被标为标题,还多出了一个 header 区块;在 0.2 时,顶部两个标题都不再是标题。阈值只需降到够用为止。4
总的经验是:版面检测决定了哪些内容能进入你的 Markdown,而它对分辨率和压缩很敏感。每遇到一种新的文档类型,都抽查几页,与保留了 OCR 找到的每一行的 overall_ocr_res 对照。
表格#
表格识别默认开启。分类模型先判断每个表格是有线表(带框线)还是无线表,然后结构模型和单元格模型把它重建为 HTML。页面上的每个表格都会进入 table_res_list,同样的 HTML 也会嵌入 Markdown。1
for res in pipeline.predict("invoice.png"):
    for i, table in enumerate(res["table_res_list"]):
        html = table["pred_html"]          # "<html><body><table>..."
        cells = table["cell_box_list"]     # 每个单元格一个框,页面坐标
        print(i, len(cells), html[:80])
    res.save_to_html(save_path="output")   # 每个表格一个 .html 文件
res.save_to_xlsx(save_path="output") # 每个表格一个 .xlsx 文件在我们的发票上,cell_box_list 有 24 个框,每个单元格一个;论文页上是 12 个。每个条目还有 table_ocr_pred,即表格内部的原始 OCR 结果。4影响表格行为的 predict() 选项有:2
| 参数 | 默认值 | 适用场景 |
|---|---|---|
use_table_orientation_classify | True | 表格在页面上可能旋转了 90°/180°/270°。 |
use_ocr_results_with_table_cells | True | 按预测的单元格边界切分 OCR 结果并重新识别,避免文字跨单元格丢失。 |
use_e2e_wired_table_rec_model | False | 有线表:只用结构模型,不用单元格检测模型。 |
use_e2e_wireless_table_rec_model | True | 无线表默认就只用结构模型。 |
use_wired_table_cells_trans_to_html | False | 直接用检测到的有线表单元格框生成 HTML(适合规整的网格)。 |
use_wireless_table_cells_trans_to_html | False | 同上,用于无线表。 |
如果你只需要表格、不需要版面分析,单独的 table_recognition_v2 产线(TableRecognitionPipelineV2)更轻量。
公式#
公式识别默认开启,使用 PP-FormulaNet_plus-L。每个公式都会出现在 formula_res_list 中,带有 rec_formula(LaTeX),并在 Markdown 中以 $$…$$ 块的形式出现——上面的论文页就是真实的例子。14L 模型精度最高,也是整条产线中最重的部分,远超其他模型。百度官方的数据(Tesla T4 GPU / Xeon Gold 6271C CPU):1
| 模型 | En-BLEU | Zh-BLEU | CPU 毫秒(高性能模式) | 大小 |
|---|---|---|---|---|
PP-FormulaNet_plus-L(默认) | 92.22 | 90.64 | 3125.58 | 698 MB |
PP-FormulaNet_plus-M | 91.45 | 89.76 | 1615.80 | 592 MB |
PP-FormulaNet_plus-S | 88.71 | 53.32 | 260.99 | 248 MB |
对于在 CPU 上处理的纯英文文档,按这些数据,formula_recognition_model_name="PP-FormulaNet_plus-S" 每个公式大约快 12 倍,英文精度略有损失(中文则损失很大)。如果你的文档没有数学公式,use_formula_recognition=False 可以完全跳过这个模型。使用 engine="onnxruntime" 时也必须加上这个开关,因为那里暂不支持公式模型。1
印章与图表#
两者默认都关闭。use_seal_recognition=True 会加入 PP-OCRv4_server_seal_det 来识别印章上的弯曲文字——这在中文发票和合同上很常见——它有自己的 seal_det_* 阈值,结果写入 seal_res_list。1use_chart_recognition=True 会用 PP-Chart2Table 把柱状图、折线图和饼图转换为表格,这是一个 0.58B 参数、约 1.4 GB 的模型。1百度给出的质量数据前后不一:使用文档报告的“Model Score”为 75.98,3.1.0 的发布说明则是 RMS-F1 80.60%——可能是不同的指标。这两项都不在我们的测试范围内;鉴于模型体积,图表识别在 CPU 上会比较慢。
重要参数#
所有构造参数的默认值都是 None,意思是“使用 PaddleX 配置”。使用文档公布了这些参数最终对应的值——但对其中一些设置,PaddleOCR 3.7.0 实际加载的配置却不一样:13
| 参数 | 文档写的 | PaddleX 3.7.2 配置 | 作用 |
|---|---|---|---|
text_det_limit_side_len | 960 | 736 | 文本检测输入的目标尺寸。 |
text_det_limit_type | max | min | 限制作用于长边还是短边。 |
text_det_unclip_ratio | 2.0 | 1.5 | 每个文本框的外扩程度。 |
layout_threshold | 0.5 | 按类别,0.3–0.5 | 版面置信度阈值;可传浮点数或 {class_id: value}。 |
text_det_thresh / text_det_box_thresh | 0.3 / 0.6 | 0.3 / 0.6 | 文本的像素阈值和检测框得分阈值。 |
layout_nms / layout_merge_bboxes_mode | True / large | — | 版面框重叠的处理方式。 |
use_region_detection | True | True | 按分栏/区域分组,用于阅读顺序。 |
format_block_content | False | False | 在 JSON 中把每个 block_content 格式化为 Markdown。 |
markdown_ignore_labels | number, footnote, header, header_image, footer, footer_image, aside_text | 不写入 Markdown 的区块。 | |
以配置为准。我们保存的 JSON 记录了实际使用的设置:overall_ocr_res.text_det_params 显示为 limit_side_len 736, limit_type "min", unclip_ratio 1.5, max_side_limit 4000——是配置里的值,而不是文档里的值。4如果你按文档调了 PP-StructureV3 的参数却看不到变化,原因就在这里。
推理引擎相关选项同样以关键字参数传入:device、engine、enable_mkldnn(默认 True)、cpu_threads(默认 10)、enable_hpi、use_tensorrt、precision,以及用于完整 YAML 覆盖的 paddlex_config。1
结果里有什么#
每页的结果都是一个类似字典的对象。JSON 文件包含相同的字段:14
| 字段 | 内容 |
|---|---|
parsing_res_list | 按阅读顺序排列的区块:block_label(text、paragraph_title、table、formula、figure_title、footer…)、block_content、block_bbox、block_id、block_order。被忽略的标签其 block_order: null。 |
layout_det_res | 原始版面框,带标签和得分。 |
overall_ocr_res | 每个文本行:rec_texts、rec_scores、rec_polys、rec_boxes,以及 text_det_params。我们的发票有 52 行。 |
table_res_list | 每个表格的 pred_html、cell_box_list、table_ocr_pred。 |
formula_res_list | rec_formula(LaTeX)、rec_polys、formula_region_id。 |
seal_res_list | 印章文字(开启时)。 |
model_settings、width、height、page_index、page_count | 运行设置和页面信息(图片输入时 page_index 为 None)。 |
res.markdown 是一个字典,包含 markdown_texts、markdown_images、page_continuation_flags、page_index 和 input_path;res.img 提供可视化图像(layout_det_res、overall_ocr_res 等)。1
保存:Markdown、JSON、Word、HTML、Excel#
我们对结果调用了每一个保存方法。六个开箱即用,一个需要额外安装包:4
| 方法 | 输出 | 我们的结果 |
|---|---|---|
save_to_markdown(path) | {name}.md,外加一个存放表格、公式和图片截图的 imgs/ 文件夹 | 成功 |
save_to_json(path) | {name}_res.json,包含上面所有字段 | 成功 |
save_to_img(path) | 版面、OCR 和阅读顺序的可视化图 | 成功 |
save_to_html(path) | 每个表格一个 {name}_table_1.html | 成功 |
save_to_xlsx(path) | 每个表格一个 {name}_table_1.xlsx | 成功 |
save_to_word(path) | {name}.docx(PaddleOCR 3.5.0 新增) | 安装 python-docx 之前一直失败 |
save_to_latex(path) | {name}.tex(使用文档中未提及) | 成功 |
PDF 输入时,文件名会带上页码后缀:report_0.md、report_1.md 依此类推。save_path 请传目录而不是文件名,否则各页会互相覆盖。1
结果对象还有 save_all(path),会一次运行所有保存方法——这和命令行的 --save_path 做的事情一样,这也是命令行在缺少 python-docx 时同样失败的原因。
CPU 上的性能#
这里的所有测试都在 4-vCPU Intel Xeon @ 2.10 GHz、15 GB 内存、无 GPU 的机器上运行,使用 CPU 上的 PaddlePaddle 3.2.0 并开启默认的 oneDNN 加速。4
| 运行(热启动,即首次调用之后) | 默认模型 | PP-OCRv6 文本模型 |
|---|---|---|
| 发票,1240 × 1754 px | 14.9 s | 13.4 s |
| 论文页,1240 × 1600 px* | 15.2–16.5 s | 14.1–16.2 s |
| 2 页 PDF(两页合计)* | — | 25.1 s |
*在第二个会话中测得,当时机器上还有其他任务在运行,请视为近似值;发票的数据来自一次干净的运行。从我们的测试中得出三点实用建议:
- 首次调用很慢。创建产线要加载大约十几个模型(第一次运行还要下载),第一次
predict()还要预热。产线只创建一次,然后对所有文件复用。 - 预留约 5 GB 内存。这是加载并运行默认产线时我们的 Python 进程占用的内存(常驻内存)。4 GB 的机器会很吃力。
- 关掉不需要的功能是最有效的手段。按百度自己的表格,使用 L 模型的公式识别是最重的阶段(在他们的 CPU 上每个公式超过 3 秒);
use_formula_recognition=False、use_chart_recognition=False(默认已关闭)以及换用 S 公式模型都能缩短耗时。1
百度公布的数据快得多,因为他们用的是 GPU 或大型服务器 CPU。对于默认配置,他们的 280 张图片基准报告:A100 上每张 1.38 s,A10 上 1.74 s,T4 上 3.70 s;“轻量”配置在 Intel Xeon 8350C CPU 上每张 3.74 s,在 Apple M4 上 12.22 s。6这些是我们没有复现的官方数据。
| 百度本地测试(925 页 PDF) | V100 | A100 |
|---|---|---|
| Server OCR,FormulaNet-L,无图表,最长边 4096 | 1.77 s/页 | 1.12 s/页 |
| 同上,开启图表识别 | 4.09 s/页 | 2.76 s/页 |
| Mobile OCR,FormulaNet-M,无图表,最长边 1200 | 0.99 s/页 | 0.64 s/页 |
同一来源显示:图表识别会让每页耗时增加一倍以上,而 mobile/轻量配置大约能减半。使用 server 模型时,V100 上的峰值显存为 17.0 GB,A100 上为 21.8 GB;轻量配置下分别为 8.6 GB 和 11.4 GB。6
从 PaddleOCR 2.x 的 PPStructure 迁移#
PPStructure 在 3.x 中已被移除,from paddleocr import PPStructure 现在会抛出 ImportError。它的替代者是 PPStructureV3,而且与 PaddleOCR 类不同,它没有兼容层:每个旧关键字参数都会抛出 ValueError: Unknown argument: …。9
| 2.x | 3.x |
|---|---|
PPStructure(use_gpu=True) | PPStructureV3(device="gpu:0")(或 "cpu") |
PPStructure(show_log=False) | 已移除;请使用 Python logging |
table=True / formula=True | use_table_recognition / use_formula_recognition(公式现在默认开启) |
image_orientation=True | use_doc_orientation_classify=True |
layout=False、ocr=False | 没有对应参数;请使用 PaddleOCR 或 TableRecognitionPipelineV2 |
det_model_dir、rec_model_dir、use_angle_cls | text_detection_model_dir、text_recognition_model_dir、use_textline_orientation |
layout_score_threshold | layout_threshold |
recovery=True、convert_info_docx() | res.save_to_word() / res.save_to_markdown() |
save_structure_res()、to_excel() | res.save_to_json()、res.save_to_xlsx() |
engine(img) | pipeline.predict(img) |
mode='kie' | PP-ChatOCRv4(paddleocr[ie]) |
命令行 --type structure --recovery true | paddleocr pp_structurev3 -i file --save_path out/ |
我们的 迁移指南 有完整的映射表,还有一个能自动改写旧代码的转换工具。
什么时候不该用 PP-StructureV3#
- 你只需要文字。直接用 PaddleOCR 搭配 PP-OCRv6 更快:在我们的机器上,PP-OCRv6 medium 识别同一张发票用 PaddlePaddle 需要 9.3 s,用 ONNX Runtime 需要 5.7 s,PP-OCRv6 small 只要 1.9 s(基准测试(英文))。它还会返回每一行及其检测框,处理表单时这往往正是你需要的。
- 你最看重困难文档上的精度,而且有 GPU。在 OmniDocBench v1.5(第三方)上,PP-StructureV3 总分 86.73;PaddleOCR-VL-1.5 为 94.50。7杂乱的扫描件、手写体和复杂版面正是 PaddleOCR-VL 的用武之地。
- 表单与键值对抽取。如我们的发票所示,标签/值对在 Markdown 中会被合并成连续的文字。请使用行级 OCR 结果,或 PP-ChatOCRv4 这类信息抽取产线。
- 原生数字 PDF。如果 PDF 本身已有文本层,直接提取文本可以完全避免 OCR 错误,耗时也只是零头;PP-StructureV3 适合扫描件和纯图片 PDF。对于 Word、Excel 和 PowerPoint 文件,PaddleOCR 的
doc2md无需任何 OCR 即可转换。 - 小机器。默认产线要加载大约十几个模型,其中包括一个 698 MB 的公式模型。在低内存服务器上,请关闭公式和图表识别,或使用轻量模型。
还没拿定主意?我们的 OCR 工具对比(英文) 把 PP-StructureV3 与 Docling、MinerU 等工具放在一起比较。
常见问题#
如何导入 PP-StructureV3?
from paddleocr import PPStructureV3——注意大小写和 V3。它需要 pip install "paddleocr[doc-parser]";不装这个 extra 会报“A dependency error occurred during pipeline creation”。
PP-StructureV3 需要 GPU 吗?
不需要。我们在没有 GPU 的 4-vCPU Xeon 上运行,每页约 13–15 秒。处理量大时 GPU 会有帮助:百度报告默认配置在 A100 上每张图片 1.38 s。
如何用 PaddleOCR 把 PDF 转成 Markdown?
运行 PPStructureV3().predict("file.pdf"),收集每一页的 res.markdown,再把列表传给 pipeline.concatenate_markdown_pages()。上面的 完整脚本 还会保存 Markdown 中引用的图片。
为什么 PPStructure(use_gpu=True) 会报错?
PPStructure 在 PaddleOCR 3.x 中已被移除,use_gpu 也已彻底不存在。请使用 PPStructureV3(device="gpu:0")。所有 2.x 的关键字参数名在 PPStructureV3 上都会报“Unknown argument”;见 映射表。
如何把表格导出为 Excel 或 HTML?
调用 res.save_to_xlsx("output") 或 res.save_to_html("output"),或者直接读取 res["table_res_list"][i]["pred_html"]。同样的 HTML 也嵌入在 Markdown 中。
为什么 Markdown 里少了一些文字?
页眉、页脚、页码、脚注和旁注默认通过 markdown_ignore_labels 排除。它们仍然在 JSON 里。传入 markdown_ignore_labels=[] 即可包含它们。
选 PP-StructureV3 还是 PaddleOCR-VL?
如果你用 CPU、需要表格单元格或文本行坐标,或者希望每个步骤都是可替换的小模型,选 PP-StructureV3。如果你有 GPU 并且想要最高精度,选 PaddleOCR-VL:它在 OmniDocBench v1.5 上得分 94.50,而 PP-StructureV3 为 86.73。
可以在 PP-StructureV3 里使用 PP-OCRv6 吗?
可以,我们也推荐这样做。传入 text_detection_model_name="PP-OCRv6_medium_det" 和 text_recognition_model_name="PP-OCRv6_medium_rec"。ocr_version="PP-OCRv6" 不起作用——对这个类来说,该参数最高只到 PP-OCRv5。
参考来源
- PP-StructureV3 使用教程,docs/version3.x/pipeline_usage/PP-StructureV3.en.md(仓库 commit dab3fe3,2026-09-16):模块(第 9–19 行)、模型表(83–891)、测试硬件(917–926)、命令行与 Python(963–1781)、参数默认值(1803–2470)、结果字段与方法(2771–2992)。中文版:PP-StructureV3.md(行号以英文版为准)。
- PaddleOCR 3.7.0 包源码(PyPI wheel),
paddleocr/_pipelines/pp_structurev3.py:__init__参数(32–101)、ocr_version仅限 PP-OCRv3–v5(28、103–106)、lang→ 模型映射(530–660)、predict默认值(148–185)、concatenate_markdown_pages(300–301)、命令行子命令(696)。paddleocr.dev 于 2026-10-27 阅读。 - PaddleX 3.7.2 wheel(PyPI,2026-06-25),
paddlex/configs/pipelines/PP-StructureV3.yaml:默认模型(第 25–233 行)、开关与markdown_ignore_labels(4–20)、文本检测设置(112–117)、各类别的版面阈值(28–48)。另见inference/pipelines/layout_parsing/pipeline_v2.py:1323-1378(concatenate_markdown_pages返回MarkdownResult)和inference/common/result/mixin.py:69-84(save_to_word)。 - paddleocr.dev 测试,2026-10-27:Linux x86-64,4 vCPU Intel Xeon @ 2.10 GHz,15 GB 内存,无 GPU,Python 3.13,paddlepaddle 3.2.0,paddleocr 3.7.0,paddlex 3.7.2。脚本和原始输出(Markdown + JSON)见
_src/data/bench/structure/;样例图片见 /assets/samples/invoice.webp 和 /assets/samples/paper-page.webp。 - PaddleOCR README.md:PP-StructureV3 的定位与单元格级坐标(第 41 行)、3.5.0 版于 2026-04-21 新增 DOCX 导出(97、101);3.0 版发布于 2025-05-20(
docs/update/update.en.md:128,134)。 - PP-StructureV3 算法文档,
docs/version3.x/algorithm/PP-StructureV3/PP-StructureV3.en.md:本地速度测试(305–921)、服务化测试(922–950)、280 张图片的产线基准(952–1497)、CPU 常见问题中的“约 3.74 秒”(1518)。均为官方数据。 - OmniDocBench README,
v1_5分支(opendatalab/OmniDocBench):PP-StructureV3 总分 86.73,第 806–817 行。第三方数据。 - PP-OCRv6 语言覆盖,
docs/version3.x/algorithm/PP-OCRv6/PP-OCRv6.en.md:3:medium 和 small 用一个模型识别 50 种语言。 - 2.x → 3.x 参数映射:
paddleocr/_common_args.py:52-54(“Unknown argument”)、docs/update/upgrade_notes.en.md:73、paddleocr 2.10.0 的ppstructure/utility.py,以及命令行--save_path的行为paddleocr/_utils/cli.py:41-45,68-73;汇总于我们的 迁移指南。